反應式程式設計在用戶端程式設計當中的應用相當廣泛,而當前在服務端中的應用相對被提及較少。本篇將介紹如何在服務端程式設計中應用回應時程式設計來改進資料庫操作的性能。
開篇就是結論
接續上一篇《談反應式程式設計在服務端中的應用,資料庫操作優化,從 20 秒到 0.5 秒'》之後,這次,我們帶來了關於利用反應式程式設計進行 upsert 優化的案例說明。建議讀者可以先閱讀一下前一篇,這樣更容易理解本篇介紹的方法。
同樣還是利用批量化的思路,將單個 upsert 操作批量進行合併。已達到減少資料庫連結消耗從而大幅提升性能的目的。
業務場景
在最近的一篇文章《十万同时在线用户,需要多少内存?——Newbe.Claptrap 框架水平扩展实验》中。我們通過啟動多個常駐於記憶體當中的 Claptrap 來實現快速驗證 JWT 正確性的目的。
但,當時有一個技術問題沒有得到解決:
Newbe.Claptrap 框架設計了一個特性:當 Claptrap Deactive 時,可以選擇將快照立即保存到資料庫。因此,當嘗試從集群中關閉一個節點時,如果節點上存在大量的 Claptrap ,那麼將產生大量的資料庫 upsert 操作。瞬間推高資料庫消耗,甚至導致部分錯誤而保存失敗。
一點點代碼
有了前篇的IBatchOperator,那麼留給這篇的代碼內容就非常少了。
首先,按照使用上一篇的 IBatchOperator 編寫一個支援操作的 Repository,形如以下代碼:
public class BatchUpsert : IUpsertRepository
{
    private readonly IDatabase _database;
    private readonly IBatchOperator<(int, int), int> _batchOperator;

    public BatchUpsert(IDatabase database)
    {
        _database = database;
        var options = new BatchOperatorOptions<(int, int), int>
        {
            BufferCount = 100,
            BufferTime = TimeSpan.FromMilliseconds(50),
            DoManyFunc = DoManyFunc
        };
        _batchOperator = new BatchOperator<(int, int), int>(options);
    }

    private Task<int> DoManyFunc(IEnumerable<(int, int)> arg)
    {
        return _database. UpsertMany(arg. ToDictionary(x => x.Item1, x => x.Item2));
    }

    public Task UpsertAsync(int key, int value)
    {
        return _batchOperator.CreateTask((key, value));
    }
}
然後,只要實現對應資料庫的 UpsertMany 方法,便可以很好地完成這項優化。
各種資料庫的操作
結合 Newbe.Claptrap 現在項目的實際。目前,被支援的資料庫分別有 SQLite、PostgreSQL、MySql 和 MongoDB。以下,分別對不同類型的資料庫的批量 Upsert 操作進行說明。
由於在 Newbe.Claptrap 專案中的 Upsert 需求都是以主鍵作為對比鍵,因此以下也只討論這種情況。
SQLite
根據官方文檔,使用 INSERT OR REPLACE INTO 便可以實現主鍵衝突時替換數據的需求。
具體的敘述格式形如以下:
INSERT OR REPLACE INTO TestTable (id, value)
VALUES
(@id0,@value0),
...
(@idn,@valuen);
因此只要直接拼接語句和參數調用即可。需要注意的是,SQLite 的可傳入參數預設為 999,因此拼接的變數也不應大於該數量。
PostgreSQL
众所周知,PostgreSQL 在进行批量写入时,可以使用高效的 COPY 语句来完成数据的高速导入,这远远快于 INSERT 语句。但可惜的是 COPY 并不能支持 ON CONFLICT DO UPDATE 子句。因此,无法使用 COPY 来完成 upsert 需求。
因此,我们还是回归使用 INSERT 配合 ON CONFLICT DO UPDATE 子句,以及 unnest 函数来完成批量 upsert 的需求。
具體的敘述格式形如以下:
INSERT INTO TestTable (id, value)
VALUES (unnest(@ids), unnest(@values))
ON CONFLICT ON CONSTRAINT TestTable_pkey
DO UPDATE SET value=excluded.value;
其中的 ids 和 values 分別為兩個等長的陣組物件,unnest 函數可以將陣列物件轉換為行數據的形式。
注意,可能會出現 ON CONFLICT DO UPDATE command cannot affect row a second time 錯誤。
因此如果嘗試使用上述方案,需要在傳入資料庫之前,先在程式中去重一遍。而且,通常來說,在程式中進行一次去重可以減少向資料庫中傳入的數據,這本身也很有意義。
MySql
MySql 與 SQLite 類似,支援REPLACE 語法。具體語句形式如下:
REPLACE INTO TestTable (id, value)
VALUES
(@id0,@value0),
...
(@idn,@valuen);
MongoDB
MongoDB 原生支援 bulkWrite 的批量傳輸模式,也支援 replace 的 upsert 語法。因此操作非常簡單。
那麼這裡展示一下 C# 操作方法:
private async Task SaveManyCoreMany(
    IDbFactory dbFactory,
    IEnumerable<StateEntity> entities)
{
    var array = entities as StateEntity[] ?? entities. ToArray();
    var items = array
        . Select(x => new MongoStateEntity
        {
            claptrap_id = x.ClaptrapId,
            claptrap_type_code = x.ClaptrapTypeCode,
            version = x.Version,
            state_data = x.StateData,
            updated_time = x.UpdatedTime,
        })
        . ToArray();

    var client = dbFactory.GetConnection(_connectionName);
    var db = client. GetDatabase(_databaseName);
    var collection = db. GetCollection<MongoStateEntity>(_stateCollectionName);

    var upsertModels = items. Select(x =>
    {
        var filter = new ExpressionFilterDefinition<MongoStateEntity>(entity =>
            entity.claptrap_id == x.claptrap_id && entity.claptrap_type_code == x.claptrap_type_code);
        return new ReplaceOneModel<MongoStateEntity>(filter, x)
        {
            IsUpsert = true
        };
    });
    await collection. BulkWriteAsync(upsertModels);
}
這是從 Newbe.Claptrap 專案業務場景中給出的代碼,讀者可以結合自身需求進行修改。
通用型解法
優化的本質是減少資料庫連結的使用,盡可能在一個鏈接內完成更多的工作。因此如果特定的資料庫不支援以上資料庫類似的操作。那麼還是存在一種通用型的解法:
- 以盡可能快地方式將數據寫入一臨時表
- 將暫時傳表的數據已連表 update 的方式更新的目標表
- 刪除暫存表
性能測試
以 SQLite 為例,嘗試對 12345 條數據進行 2 次 upsert 操作。
單條併發:1 分 6 秒
批量處理:2.9 秒
樣例中不包含有 MySql、PostgreSQL 和 MongoDB 的樣例,因為沒有優化之前,在不提高連接池的情況下,一併發基本就爆炸了。所有優化的結果是直接解決了可用性的問題。
所有的範例代碼均找到。如果 Github Clone 存在困難,也可以點擊此處從 Gitee 進行 Clone
常見問題解答
此處對一些常見的問題進行解答。
用戶端是等待批量操作的結果嗎?
這是一個很多網友提出的問題。答案是:是的。
假設我們公開了一個 WebApi 作為介面,由瀏覽器調用。如果同時有 100 個瀏覽器同時發出請求。
那麼這 100 個請求會被合併,然後寫入資料庫。而在寫入資料庫之前,這些用戶端都不會得到服務端的回應,會一直等待。
這也是該合併方案區別於普通的"寫佇列,后寫庫"方案的地方。
原理上講,這種和 bulkcopy 有啥不一樣?
兩者是不相關,必須同時才有作用的功能。 首先,程式碼中的 database. InsertMany 就是你提到的 bulkcopy。
這個代碼的關鍵不是 InsertMany ,而是如何將單次的插入請求合併。 試想一下,你可以在 webapi 上公開一個 bulkcopy 的 API。 但是,你無法將來自不同用戶端的請求合併在同一個 API 裡面來調用 bulkcopy。 例如,有一萬個用戶端都在調用你的 API,那怎麼合併這些 API 請求呢?
如果如果通過上面這種方式,雖然你只是對外公開了一個單次插入的 API。你卻實現了來自不同用戶端請求的合併,變得可以使用 bulkcopy 了。這在高併發下很有意義。
另外,這符合開閉的原理,因為你沒有修改 Repository 的 InsertOne 介面,卻實現了 bulkcopy 的效果。
如果大量操作中一個操作異常失敗是否會導致被合併的其他操作全部失敗?
如果業務場景是合併會有影響,那當然不應該合併。
批量操作一個失敗,當然是一起失敗,因為底層的資料庫事務肯定也是一起失敗。
除非批量介面也支援對每個傳入的 ID 做區別對待。典型的,比如 mongodb 的 bulkcopy 可以返回哪些成功哪些失敗,那麼我們就有能力設置不同的 Tcs 狀態。
哪些該合併,哪些不該合併,完全取決於業務。樣例給出的是如果要合併,應該怎麼合併。不會要求所有都要合併。
Insert 和 Upsert 都說了,那 Delete 和 Select 呢?
筆者籠統地將該模式稱為"反應式批量處理」。。要確認業務場景是否應用該模式,需要具備以下這兩個基本的要求:
- 業務下游的批量處理是否會比累積的單條處理要快,如果會,那可以用
- 業務上游是否會出現短時間的突增頻率的請求,如果會,那可以用
當然,還需要考量,比如:下游的批量操作能否卻分每個請求的結果等等問題。但以上兩點是一定需要考量的。
那麼以 Delete 為例:
- Delete Where In 的速度會比 Delete = 的速度快嗎?試一下
- 會有突增的 Delete 需求嗎?想一下
小小工具 Zeal
筆者是一個完整存儲過程都寫不出來的人。能夠查閱到這些資料庫的文檔,全靠一款名為 Zeal 的離線文件查看免費軟體。推薦給您,您也值得擁有。
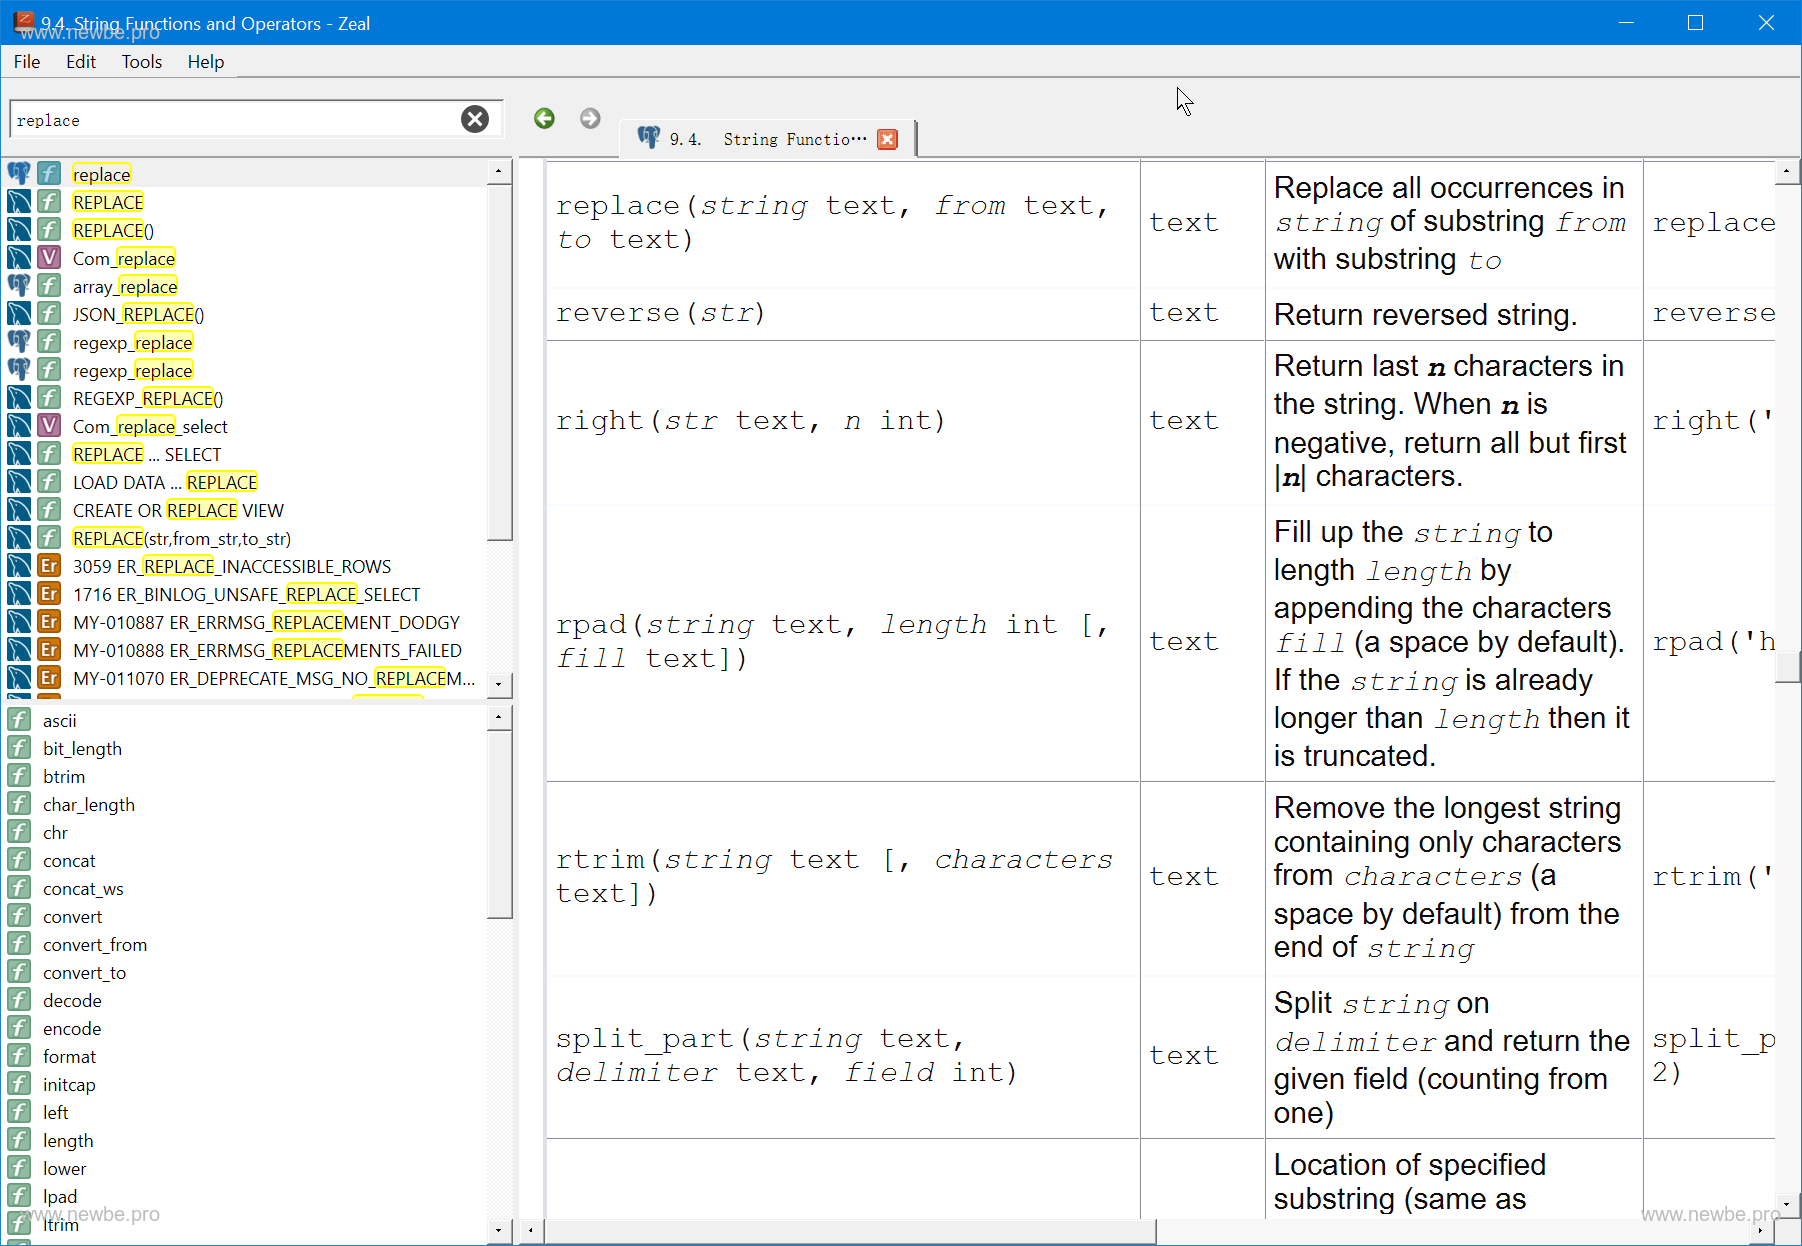
Zeal 官網位址:https://zealdocs.org/